


실시간 고속 이미지 획득을 위한 GPU 사용방법
Active Silicon
FPGA의 채택과 함께 GPU를 통한 이미지 처리가 어떻게 효율적이고 유연한 옵션이 되는지 살펴보자. GPU는 낮은 비용과 접근성을 제공하면서 CPU의 부담을 덜어주고 다른 기능을 위한 메모리와 용량을 확보해준다.
GPU를 통한 고속 이미징은 비전 시스템에 가치를 더할 수 있다
최신 GPU는 이미지와 그래픽을 처리하는 데 매우 효율적이다. GPU 구조는 특히 대용량 데이터 블록을 병렬로 처리해야 하는 애플리케이션에 적합하다. 공장자동화를 위해 카메라와 센서가 더욱 강력해짐에 따라 점점 많은 데이터를 처리해야 한다. 머신 비전 시장의 많은 산업 현장은 100% 인라인 검사로 이동하고 있으며, 그 결과 이미징 작업이 더욱 중요해지고 있다. 다양하고 복잡한 검사 대상은 여러 센서를 사용하여 더욱 짧은 시간에 스캔해야 한다.
이렇게 높은 품질 표준이 요구되면서 복잡한 계산 알고리즘을 사용해야 하며, 여기에 딥 러닝 기능도 추가되고 있다. GPU를 사용하면 CPU 없이도 모든 수준의 처리를 수행할 수 있다. 2017년 IBM은 새로운 벤치마크를 공개하는 등 개발이 이루어졌다. IBM은 이전 TensorFlow 기록보다 46배 빠르게 로지스틱 회귀 분류기를 훈련했고(70분에서 90초). 이것은 분산 훈련, GPU 가속 및 새로운 알고리즘에 탄생시켰다.
GPU 기술의 주요 공급업체인 NVIDIA와 AMD는 각각 비디오 및 DirectGMA용 API를 제공한다. 이러한 API를 사용하면 GPU 메모리가 프레임 그래버에 직접 액세스할 수 있으므로 시스템 버퍼와 CPU를 모두 건너뛸 수 있다. 프레임 그래버는 대기 시간이 매우 짧은 고속 실시간 이미지 수집을 가능하게 한다. FPGA는 병렬 컴퓨팅을 위한 기술을 제공한다. 많은 제조업체가 하드웨어에서 FPGA와 GPU 기술을 모두 사용한다.
일반적으로 GPU는 낮은 구현 비용부터 시작하며, FPGA 보다 몇 가지 장점이 있다. 게다가 GPU 소프트웨어 개발은 FPGA 펌웨어를 개발하는 것보다 훨씬 빠르고 간단하다. 시장에는 이에 대한 필요한 기술과 지식을 갖춘 많은 엔지니어가 있다. 또한 비전시스템에서 타사 소프트웨어를 사용하는 것이 더욱 간단하고 쉽다.


GPU 처리에 적합한 애플리케이션
대부분의 GPU에는 비디오 압축을 가속화하는 데 사용할 수 있는 비디오 코덱이 내장되어 있으므로 비디오 스트림을 인코딩해야 하는 애플리케이션 처리에 특히 적합하다. 프레임 그래버와 GPU는 빠른 데이터 전송 속도의 실시간 이미지 처리가 필요한 애플리케이션에 이상적인 조합이다. 예를 들어 FireBird 프레임 그래버 중 하나는 현재 노르웨이 회사인 Piql에서 개발한 새로운 시스템에서 사용되고 있다. Piql은 35mm 필름에 안전하고 검색 가능한 대용량 디지털 데이터 스토리지를 제공한다. 이 독창적인 애플리케이션은 다양한 매체의 데이터를 디지털화하고 OCR 및 인덱싱(빠른 검색을 위해)을 적용한 다음 QR 코드와 유사한 코딩 기술을 사용하여 데이터를 내구성이 높은 35mm 필름에 디지털 인쇄한다.
그런 다음 전문 스캐너를 사용하여 데이터에 액세스하여 필름에서 데이터를 다시 읽을 수 있도록 한다. 결국 데이터는 최소 500년 동안 안전하게 저장될 수 있다. Piql은 고속 이미지 획득 기능, 비용 효율적인 가격 및 다른 시스템 구성 요소와의 호환성으로 인해 리더기에 설치할 Active Silicon Firebird 프레임 그래버를 선택했다. Piql 저장 프로세스는 초당 20-24 프레임의 속도로 150mm의 35mm 필름에 데이터를 시용한다.
각 프레임은 80 MB의 데이터를 생성한다. 따라서 초당 1.6 GB의 데이터가 지속적으로 처리된다. 이 방대한 양의 데이터와 높은 연산 능력은 CPU에서 처리할 수 없었으므로 Piql은 GPU와 FPGA의 옵션을 조사했고 결국 뛰어난 시스템 유연성으로 인해 NVIDIA GPU를 선택했다. GPU 카드, 구성, 프레임 그래버 및 기타 호환 가능한 구성 요소 측면에서 더욱 많은 옵션을 사용할 수 있었다.
또 다른 흥미로운 사례는 의료 영상과 관련된 애플리케이션이다. Active Silicon은 현재 컴퓨터 비전 보조 수술 분야의 의료 애플리케이션을 위한 USB 3.0 임베디드 비전 시스템을 생산하고 있다.
현재 시스템은 최대 3개의 USB 3.0 카메라, 스테레오 비전용 가시광 카메라 2대, 비가시광 카메라 1대의 이미지 데이터를 처리하여 형광 이미지와 이미지 융합을 생성한다. 현재 4K로 이미지를 수집, 처리, 표시 및 기록할 차세대 시스템을 개발하고 있다. 최대 4대의 4K 60Hz 카메라의 이미지가 사용되어 엄청난 양의 데이터가 생성된다. FPGA, ASIC 및 GPU는 이러한 방대한 데이터 처리 요구 사항에 대한 솔루션으로 채택됐다.
CPU는 단순히 충분한 처리 능력을 제공할 수 없다. FPGA와 GPU는 테스트 조건에서 처리할 때 동일한 성능을 제공했지만, 소프트웨어 개발이 FPGA 펌웨어를 개발하는 것보다 훨씬 빠르고 간단하기 때문에 GPU가 최고의 솔루션으로 선택됐다.
ASIC은 명백한 이점을 제공하지 않았다. 이미 의료 ISO(13485)를 준수하는 소프트웨어를 구입하여 GPU에 설치할 수 있으므로 추가 테스트가 필요하지 않다. AMD GPU 대신 NVIDIA GPU 가 선택되었다. 제품은 잘 개발되었으며 상당한 라이브러리와 지원이 가능했다. 많은 엔지니어가 NVIDIA CUDA 코딩에 익숙했다.
GPU 처리 및 딥 러닝
GPU와 딥러닝은 자율 주행 차량에 사용된다. 자동화는 감지, 인식, 예측 및 계획의 4가지 영역으로 나뉘며, 사용되는 센서는 레이더, LiDAR 및 카메라이다. 딥 러닝은 도로 표지판 인식, 보행자 감지, 차선 모니터링에 사용된다. 이미지는 복잡하고 매우 다양하며 조명 및 날씨를 포함한 영향을 받는다. 실시간 처리 및 그에 따른 조치를 취해야 하는 것은 필수이다.
엄청난 양의 데이터를 관리할 수 있는 능력 때문에 GPU는 이 이미지 처리에 대한 최상의 솔루션이다. 그러나 문제는 차량 에너지 소비 수준 및 온도 관리가 포함되야 한다는 것이다. 에너지 문제에 대한 한 가지 솔루션은 차량 외부의 GPU 서버에서 신경망을 훈련시킨 다음, 완료되면 온보드 장치로 데이터를 전송하는 것이다. NVIDIA와 Intel은 모두 자율 주행을 위한 GPU 생산에 주력하고 있다. NVIDIA Tesla V100은 300W의 전력 소비로 초당 120테라 작업의 컴퓨팅 속도를 달성한다. NVIDIAJetson TX1 모바일 GPU는 VGG-16에서 초당 300기가 작업의 속도와 10W의 전력 소모로 초당 1 테라 작업의 최고 성능을 제공한다.
시스템에 딥 러닝 도입
머신 비전과 함께 딥러닝은 흥미롭고 빠르게 움직이는 검사 도구이다. 딥러닝에서는 GPU의 대규모 병렬 아키텍처가 CPU보다 맞는 선택이다. 딥 러닝은 행렬 곱셈에 크게 의존한다. 딥 러닝을 실행하는 기계는 자체적으로 데이터 또는 기능의 패턴을 찾을 수 있고 약간의 교육만 필요하기 때문에 이러한 알고리즘은 CPU에서 효과적으로 처리될 수 없다. 그렇다면 시스템에 딥 러닝을 도입할 때 GPU의 중요한 기능은 높은 메모리 대역폭과 처리 능력, 큰 비디오 RAM 크기이다. NVIDIA는 그 길을 선도해 왔으며 철저히 테스트된 옵션이다.
고속 이미지 획득 구현
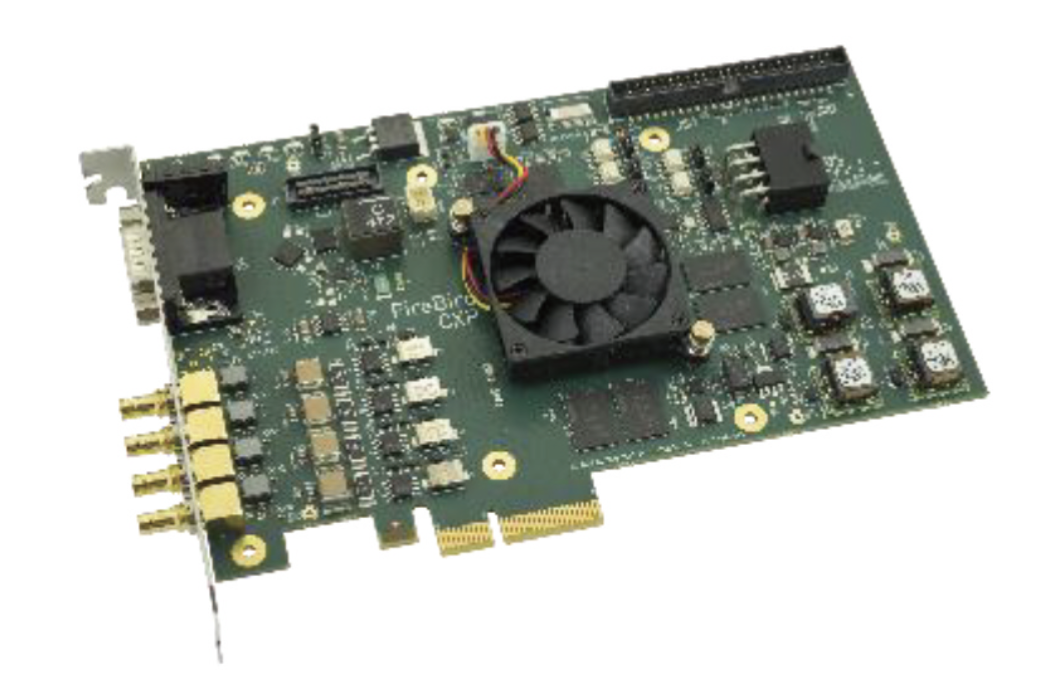
GPU는 비전 시스템에 쉽고 빠르게 이미지 획득 속도를 높이는 간단하고 비용 효율적인 방법이다. Active Silicon은 GPU 기술과 호환되는 안정적이고 강력한 구성 요소를 제공한다. Active Silicon의 Camera Link 프레임 그래버는 최대 85MHz의 클록 속도를 달성한다. 새로운 CoaXPress v2.0 쿼드 보드는 최대 50Gbps의 전송 속도로 데이터를 제공한다. 기존 시스템에 쉽게 적용되고 사용할 수 있는 소프트웨어 기술이 이미징 속도를 높이고 딥 러닝을 쉽게 구현할 수 있다.
자료 제공: Active Silicon(www.activesilicon.com)




