

비전 검사에서 활용되는 5가지 이미지 분할 기법
이미지 분할(Image Segmentation)은 컴퓨터 비전에서 모든 분석이 시작되는 핵심 단계다. 객체와 배경을 구분하고, 이미지에 담긴 정보를 의미 있는 데이터로 전환하는 과정은 결국 분할 기술에 의해 좌우된다. 전통적인 이미지 분할 기법은 주로 픽셀 밝기(intensity)에 기반해 구현되며, 일정한 조건에서는 여전히 유효하다. 그러나 조명 변화가 크거나 장면이 복잡한 산업 환경에서는 정확도와 신뢰성 측면에서 분명한 한계를 드러낸다.
이러한 제약을 극복하기 위해 머신러닝과 딥러닝 기반 이미지 분할 기법이 빠르게 확산되고 있다. 텍스처, 색상, 공간적 특징을 학습하는 최신 접근법은 분할 정밀도를 크게 향상시키며, 비전 검사를 연구 단계에서 실제 양산 환경에 적용 가능한 수준으로 끌어올리고 있다. 본 기사는 비전 검사 성능을 좌우하는 주요 이미지 분할 기법을 중심으로, 각 접근법의 특징과 적용 관점을 살펴본다.
1. 임계값 기반 분할(Threshold-Based Segmentation)
임계값 기반 분할은 픽셀의 밝기 값이 설정된 기준값보다 높은지 또는 낮은지를 판단해, 이미지를 전경(foreground)과 배경 (background)으로 구분하는 가장 기본적인 이미지 분할 기법이다. 구조가 단순하고 구현이 용이해, 초기 비전 시스템부터 현재까지 폭넓게 활용되고 있다.
이 방식은 적용 방식에 따라 전역 임계값(Global Thresholding)과 적응형 임계값(Adaptive Thresholding)으로 나뉜다. 전역 임계값은 이미지 전체에 하나의 동일한 임계값을 적용해 객체와 배경을 분리하는 방식으로, 조명 조건이 일정한 환경에서는 빠르고 안정적인 처리가 가능하다. 반면, 적응형 임계값은 이미지의 각 영역별로 서로 다른 로컬 임계값을 계산해 적용함으로써, 조명이 불균일하거나 그림자가 존재하는 환경에서도 비교적 안정적인 분할 성능을 유지할 수 있다.
임계값 기반 분할은 문서 스캐닝과 같은 분야에서 널리 활용된다. 텍스트를 이진화해 OCR(광학 문자 인식) 정확도를 높이는 데 효과적이며, 의료 영상 분야에서는 X-ray 이미지에서 뼈와 연부 조직을 분리해 보다 명확한 진단을 지원하는 데 사용된다. 이 기법의 가장 큰 장점은 연산 부담이 적고 처리 속도가 빠르다는 점이다. 알고리즘 구조가 단순해 실시간 처리가 요구되는 응용 환경에서도 효율적으로 적용할 수 있다.
다만 한계 역시 분명하다. 명암 대비가 낮거나 노이즈가 많은 이미지, 또는 전경과 배경의 밝기 분포가 서로 겹치는 경우에는 분할 정확도가 크게 저하될 수 있다. 이러한 이유로 임계값 기반 분할은 단독 기법보다는, 보다 정교한 분할 방식의 전처리 단계나 보조 수단으로 활용되는 경우가 많다.
2. 에지 기반 분할(Edge-Based Segmentation)
에지 기반 분할은 픽셀 밝기 값이 급격하게 변화하는 지점을 검출해 객체의 경계(boundary)를 식별하는 이미지 분할 기법이다. 객체의 형태와 윤곽이 비교적 뚜렷한 경우, 경계를 직접 추출함으로써 분할 결과를 얻는 방식으로, 전통적인 컴퓨터 비전 분야에서 오랫동안 활용돼 왔다.
대표적인 에지 검출 기법으로는 Canny에지 검출기(Canny Edge Detector)와 가우시안 라플라시안(LoG, Laplacian of Gaussian)이 있다. Canny 에지 검출기는 노이즈 제거, 그래디언트 계산, 비최대 억제(non-max suppression)등 여러 단계를 거치는 다단계 처리 구조를 통해, 비교적 안정적이고 정밀한 에지 검출을 구현한다. LoG 기법은 가우시안 스무딩으로 노이즈를 완화한 뒤 라플라시안 연산을 적용해, 밝기 변화가 급격한 영역을 효과적으로 검출한다.
에지 기반 분할은 산업 검사 분야에서 특히 유용하다. 기계 부품이나 제조 공정에서 발생하는 미세한 균열이나 표면 결함을 검출하는데 활용되며, 자율주행 분야에서는 차선 경계를 인식해 차량의 주행 경로 판단과 내비게이션 성능을 향상시키는 역할을 한다.
이 기법의 강점은 선명하고 명확하게 정의된 경계를 정확하게 추출할 수 있다는 점이다. 따라서 객체의 형상이 분명하고, 경계 정보 자체가 중요한 응용 분야에서는 높은 효율을 발휘한다. 반면, 노이즈에 민감하다는 한계도 존재한다. 조명 변화나 이미지 품질 저하가 발생할 경우 에지가 단편적이거나 불완전하게 검출될 수 있으며, 실제 산업 환경에서는 추가적인 후처리나 다른 분할 기법과의 결합이 필요한 경우가 많다.
3. 영역 기반 분할(Region-Based Segmentation)
영역 기반 분할은 밝기, 색상, 텍스처 등 픽셀 간 유사성을 기준으로, 이미지를 여러 개의 연결된 영역(region)으로 그룹화하는 이미지 분할 기법이다. 개별 픽셀의 경계보다는, 유사한 특성을 공유 하는 영역 단위의 구조를 파악하는 데 초점을 맞춘 것이 특징이다.
대표적인 방식으로는 영역 확장(Region Growing)과 워터셰드 알고리즘(Watershed Algorithm)이 있다. 영역 확장은 시드 포인트(seed point)에서 시작해, 유사한 특성을 가진 인접 픽셀을 순차적으로 포함시키며 영역을 확장하는 방식이다. 비교적 직관 적인 구조를 갖고 있으며, 객체 내부의 연속성이 높은 경우 안정 적인 분할 결과를 얻을 수 있다.
워터셰드 알고리즘은 이미지를 지형(topographic surface)처럼 해석해, 집수 분지(catchment basin)와 능선(ridge line)을 기준으로 영역을 분리한다. 이 방식은 복잡한 구조를 가진 이미지에서도 영역 간 경계를 효과적으로 구분할 수 있다는 장점이 있다.
영역 기반 분할은 의료 영상 분야에서 특히 활용도가 높다. MRI 영상에서 종양과 주변 조직을 분리하거나, 조직 간 경계를 비교적 자연스럽게 추출하는데 효과적이다. 위성 영상 분석에서도 수역과 식생 지역 등 넓은 영역 단위의 특성을 구분하는데 널리 사용된다.
이 기법의 강점은 연속적이고 일관된 영역을 생성할 수 있다는 점이다. 점진적인 밝기 변화가 존재하는 이미지에서도 안정적인 분할이 가능해, 경계가 명확하지 않은 객체를 다루는데 유리하다. 다만 시드 포인트 설정이나 파라미터 선택에 따라 결과가 크게 달라질 수 있으며, 조건이 적절하지 않을 경우 과도한 분할(oversegmentation)이 발생할 수 있다. 실제 산업 환경에서는 이를 보완하기 위해 전처리 단계나 다른 분할 기법과의 병행 적용이 요구되는 경우가 많다.
4. 클러스터링 기반 분할(Clustering-Based Segmentation)
클러스터링 기반 분할은 색상, 밝기, 텍스처와 같은 특징의 유사성을 기준으로 픽셀을 여러 개의 클러스터로 그룹화하는 이미지 분할 기법이다. 사전에 명확한 경계 정보를 정의하지 않고도 데이터 자체의 분포를 기반으로 분할이 이뤄진다는 점에서, 비지도 학습 방식의 대표적인 접근법으로 분류된다.
대표적인 기법으로는 K-평균 클러스터링(K-means Clustering), 평균 이동(Mean Shift), 퍼지 C-평균(Fuzzy C-means)이 있다. K-평균 클러스터링은 픽셀을 K개의 클러스터로 나눈 뒤, 각 클러 스터 내부 분산을 최소화하는 방식으로 군집을 형성한다. 비교적 구현이 간단하고 계산 효율이 높아 널리 사용된다.
평균 이동 기법은 사전에 클러스터 개수를 지정하지 않고, 데이터 밀도 추정을 통해 클러스터 중심을 자동으로 식별한다는 점에서 유연성이 높다. 퍼지 C-평균은 하나의 픽셀이 여러 클러스터에 서로 다른 소속도(degree of membership)로 동시에 속할 수 있도록 허용해, 경계가 모호한 영역을 보다 자연스럽게 표현할 수 있다.
클러스터링 기반 분할은 컬러 양자화(Color Quantization)와 같이 이미지의 색상 복잡도를 줄여 저장 공간이나 처리 효율을 개선하는데 활용된다. 또한 원격 탐사(Remote Sensing) 분야에서는 반사 특성을 기반으로 토지 피복 유형을 분류하는데 사용되며, 대규모 영상 데이터를 자동으로 분석하는 데 기여하고 있다.
이 기법의 강점은 사전 라벨링 데이터 없이도 적용할 수 있다는 점과, 다양한 특징 공간(feature space)에 유연하게 대응할 수 있다는 점이다. 환경이나 대상이 자주 변하는 경우에도 비교적 빠르게 적용할 수 있어 탐색적 분석에 유리하다.
다만 공간적 맥락(spatial context)을 직접적으로 고려하지 않는 경우가 많아, 인접 픽셀 간 관계가 중요한 영상에서는 분할 품질이 떨어질 수 있다. 또한 초기 파라미터 설정이나 클러스터 개수 선택에 따라 결과가 크게 달라질 수 있어, 실제 적용 시에는 세심한 조정이나 다른 분할 기법과의 병행이 요구된다.
5. 딥러닝 기반 분할(Deep Learning-Based Segmentation)
딥러닝 기반 분할은 대규모 데이터셋으로부터 계층적 특징 (hierarchical feature)을 학습한 신경망을 활용해, 이미지의 각픽셀을 개별적으로 분류하는 방식이다. 단순한 밝기나 색상 정보에 의존하던 기존 기법과 달리, 복잡한 패턴과 맥락을 학습함으로써 정밀한 분할 결과를 도출할 수 있다는 점이 가장 큰 특징이다.
이 접근법은 전통적인 분할 기법이 놓치기 쉬운 미세한 패턴이나 이상(anomaly)을 효과적으로 검출하며, 전체적인 모델 정확도를 크게 향상시킨다. 특히 배경이 복잡하거나 노이즈가 많은 환경에서도 안정적인 성능을 유지할 수 있어, 최근 산업용 비전 시스템의 핵심 기술로 자리 잡고 있다.
대표적인 딥러닝 기반 분할 모델로는 U-Net, Mask R-CNN, 비전 트랜스포머(Vision Transformer, ViT)가 있다. U-Net은 스킵 커 넥션(skip connection)을 포함한 인코더-디코더 구조를 통해 공간적 위치 정보를 효과적으로 보존하며, 미세한 디테일까지 포착할 수 있어 의료 영상 분야에서 널리 활용된다.
Mask R-CNN은 Faster R-CNN을 확장한 구조로, 객체를 개별 인스턴스 단위로 구분하는 마스크를 예측할 수 있어 다수의 객체가 동시에 존재하는 장면에 적합하다. 비전 트랜스포머는 트랜스 포머 기반 아키텍처를 분할 작업에 적용해, 전역적인 문맥 정보를 효과적으로 처리하는 고급 분할 성능을 제공한다.
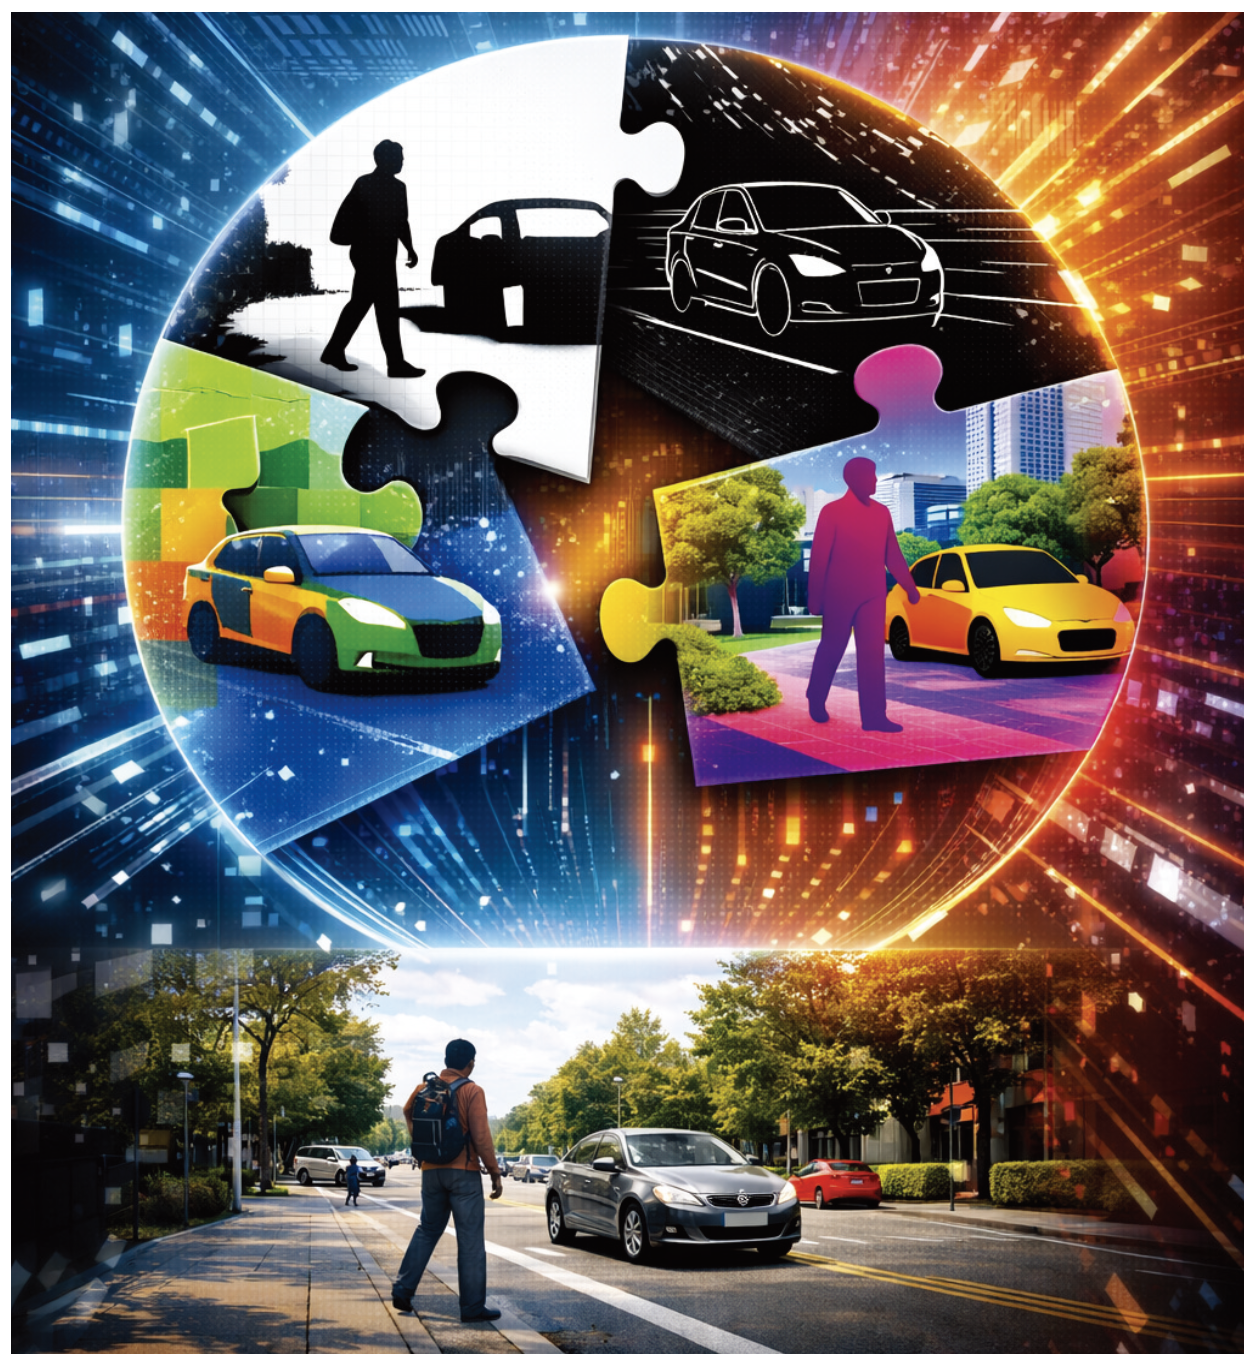
딥러닝 기반 분할을 이해하기 위해서는 CNN과 FCN의 차이도 중요하다. CNN(합성곱 신경망)은 주로 이미지 전체에서 특징을 추출해 분류 작업에 활용되는 반면, FCN(완전 합성곱 신경망)은 완전 연결 레이어를 합성곱 레이어로 대체함으로써 픽셀 단위 예측이 가능하도록 설계돼, 분할 작업에 보다 적합한 구조를 갖는다. 이러한 딥러닝 기반 분할 기법은 자율주행 차량에서 도로, 차량, 보행자를 정밀하게 분할해 주행 안전성과 인식 정확도를 높이는데 활용된다.
딥러닝 기반 분할의 가장 큰 강점은 최첨단(state-of-the-art) 수준의 정확도와 높은 강인성이다. 노이즈가 많거나 텍스처가 복잡한 환경에서도 안정적인 성능을 유지하며, 이는 전통적인 접근 법이 어려움을 겪는 영역이다.
다만 이러한 성능은 대가를 요구한다. 모델 학습을 위해 대규모 라벨링 데이터셋이 필요하며, 연산량이 많아 GPU 등 전용 하드웨어가 요구되는 경우가 많다. 이로 인해 초기 도입 비용과 시스템 설계 난이도가 높아질 수 있다는 점은 여전히 고려해야 할 과제로 남아 있다.
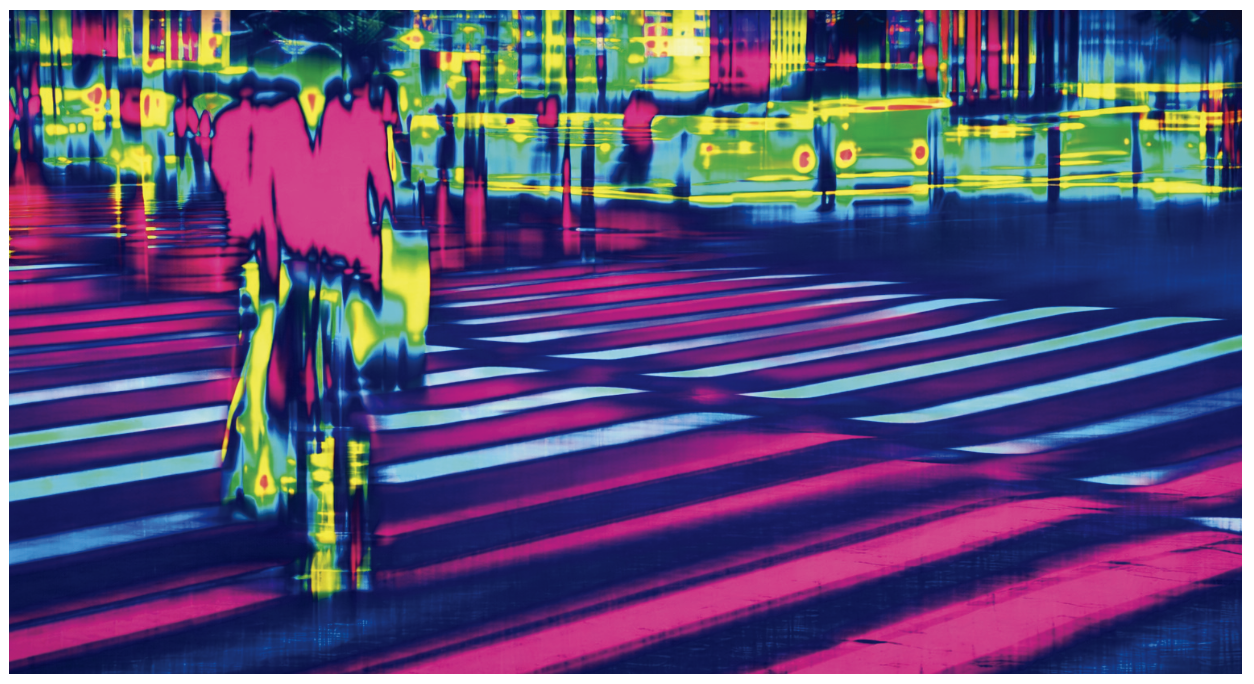
▲ 이미지 분할 결과를 통해 기계가 해석한 시각 정보의 예시
자료제공: Averroes(www.averroes.ai)