


영상의 특징으로 검색하는 시대
영상 속 특징 추출하는 기술이 핵심...
MVS기술 미래 동력 산업으로 급부상
모바일 비주얼 검색(MVS: Mobile Visual Search) 기술은 스마트폰 환경에서 질의영상(Query Image)의 특징을 검출하고, 그 주변 영역의 정보를 이용하여 추출한 서술자를 미리 구축된 영상정보 DB와 비교하여 검색하는 기술을 말한다. 영상처리기술과 IT의 융합이라는 측면에서 영상처리기술의 새로운 필드가 되고 있는 모바일 비주얼 검색과 관련한 기술동향을 함께 살펴보고자 한다.
스마트폰 보급 확대와 네트워크 환경발달은 영상 데이터의 급속한 증가로 이어지고 있다. 페이스북(Facebook)에는 매일 3백만 장의 사진이 업로드 되고 있으며, 유튜브(Youtube)에는 한 사람이 1,700년 동안 시청해야 다 볼 수 있는 비디오가 업로드 되어 있다고 한다. 특히 모바일 데이터의 트래픽 증가율은 연평균 66%에 달할 정도로 빠르게 증가하고 있다.
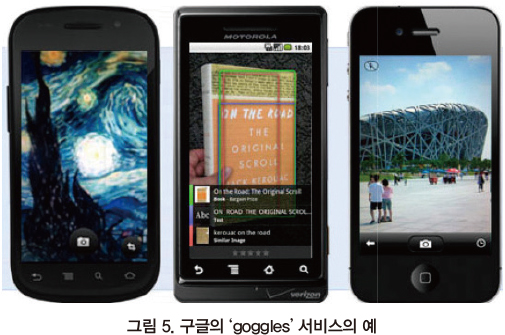
보통 ‘검색(search)’의 어려움을 측정하는 기준을 ‘평균 검색어 수’로 판단하는데 그 수 역시 지속적으로 증가하고 있으며, 이 때문에 편리하고 정확한 검색 방법에 대한 요구가 높아지고 있다. 특히 영상 기반의 정보검색은 사용자가 명칭이나 키워드를 모를 경우 비주얼 콘텐츠로 검색할 수 있다는 측면에서 검색효과를 크게 증가시킬 수 있을 것으로 기대하고 있다. 이에 따라, 세계 각국의 IT 기업들은 영상 기반 정보검색기술을 차세대 성장산업으로 보고 기술 및 서비스 개발에 주력하고 있으며, 특히, 모바일 환경에 적합한 모바일 비주얼 검색기술에 집중하고 있다. 구글의 ‘Goggles’, 아마존의 ‘Flow’, 마이크로 소프트의 ‘Bing Vision’, 퀄컴의 ‘Vuforia’ 등의 서비스가 대표적이며, 이와 함께 관련기술의 표준화도 활발하게 진행되고 있는 상황이다.
MVS 기술의 정의와 조건
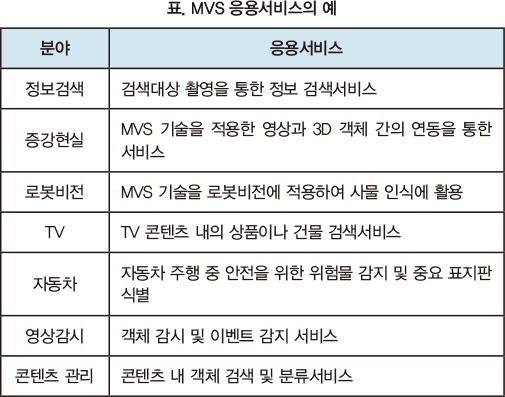
모바일 비주얼 검색(MVS: Mobile Visual Search)기술은 사용자가 검색하고자 하는 대상을 촬영하거나 촬영된 이미지를 활용하여 미리 구축된 영상 DB 검색을 통해 촬영 대상과 연계된 정보를 얻는 것에서 시작된다.
예를 들어 어떠한 제품을 촬영하여 이를 DB에서 검색하면 제품명, 가격, 기능 및 판매처 등 부가정보를 얻을 수 있다. 또는 건물을 촬영하면, 무슨 건물인지를 촬영한 이미지를 통해 인식하여 건물 내 또는 주변 정보를 제공받을 수 있다.
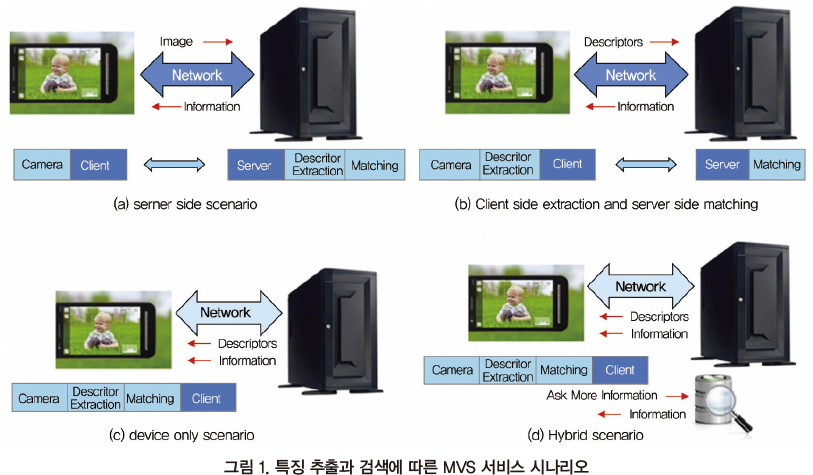
이러한 MVS 기술은 크게 ‘특징 추출’과 ‘검색’의 단계로 이루어지며, 그 주체에 따라 4가지의 시나리오가 가능하다. 그림 1 참고.
이러한 다양한 서비스 시나리오를 만족시키기 위해서는 ▲강인성(robustness) ▲구별성(pairwise independence) ▲일반성(generality) ▲계층성(scalability) ▲검색 효율성(DB efficiency) ▲하드웨어 구현지원(support to hardware implementation) 등 핵심적인 6가지 요구사항을 만족해야 한다.
자세히 살펴보면, ‘강인성’은 조명과 같은 환경변화 및 촬영시점의 변화에 강인해야 함을 의미한다. ‘구별성’은 서로 다른 객체를 포함한 영상 특징은 구별되어야 한다는 것이고, ‘일반성’은 하나의 특징으로 여러 응용 분야에 활용이 가능해야 함을 말한다. ‘계층성’은 네트워크 환경 및 다양한 단말을 지원할 수 있도록 검출한 특징의 크기를 계층적으로 구성하고 상호호환성(interoperability)을 확보하여야 함을, ‘검색 효율성’은 대용량 영상데이터를 효율적으로 검색할 수 있는 구조가 지원되어져야 함을 의미한다. 마지막으로 하드웨어 구현지원(support to hardware implementation)은 ‘고속’으로 특징 추출과 검색이 이루어질 수 있도록 하는 하드웨어 구현이 필요하다는 것을 말한다.
MVS 기술의 요소기술과 역할
MVS 기술에 있어 단연 중요한 것은 영상에서 ‘어떻게’ 특징을 분석·추출하고, 그것을 데이터화하여 기존 DB와 정합·검증을 하느냐이다. 각각의 과정을 하나의 요소기술로 보았을 때 MVS의 과정 및 각 기술의 역할은 다음과 같다.
(1) 특징 검출(feature detection)
모바일 비주얼 검색기술에서 가장 중요한 요소기술인 ‘특징 검출 기술’은 영상 내에서 시점이나 조명 변화에 상관없이 변하지 않는 영역을 찾아내는 기술이다. 일반적으로 영상 변형 시 불변성을 가지는 위치를 선택하도록 설계하는데, Harris 검출기, Hessian 검출기, Harris-Laplace 검출기, SIFT(Scale Invariant Feature Transform) 검출기, MSER(Maximally Stable Extremal Regions) 검출기, SURF(Speeded Up Robust Features) 검출기, FAST 검출기 등이 있다. 이중 SIFT 검출기와 SURF 검출기, FAST 검출기가 성능 및 속도 면에서 우수해 많이 활용되고 있다.
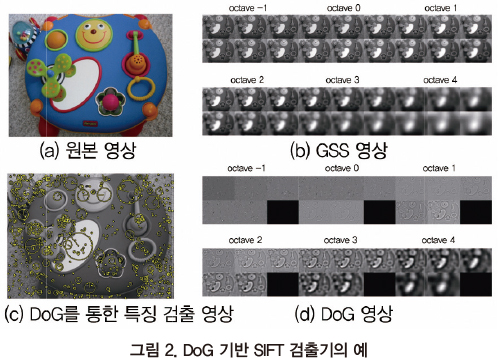
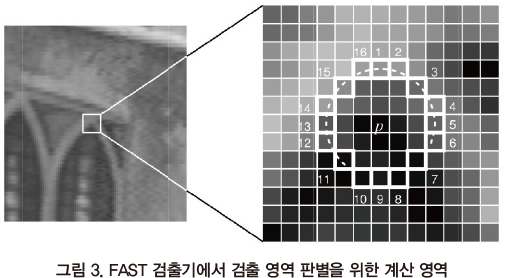
SIFT 검출기는 그림 2와 같이 Gaussian Scale Space에서 Laplacian 필터의 응답에 대한 지역 극점을 찾는 방법으로 LoG(Lapalcian of Gaussian)의 계산량을 DoG를 통해 줄이는 방법이다. SUFT 검출기는 적분 이미지(Integral Image)와 박스 필터(Box filters)를 활용하여 Hessian의 근사값으로 극점을 찾고, 영상의 크기를 줄이는 대신 필터의 크기를 키워 Scale Space를 계산하는 속도를 개선한 것이다. FAST 검출기는 Bresenham의 알고리즘 기반으로 그림 3과 같이 그린 원 위의 픽셀값과 중심의 픽셀값 사이의 관계를 이용해서 빠른 특징 추출을 하는 방법이다.
(2) 서술자 추출(descriptor extraction)
검출된 특징의 주변 영역을 이용하여 강인하며, 구별 가능한 특징 벡터를 추출하는 과정으로서, 특징 검출에 의해서 시점 및 조명 변화 등에 불변한 영역을 찾은 후에는 영상의 지역정보를 이용하여 구별이 가능하도록 서술자를 추출한다. 서술자 추출 방법으로는 대표적인 SIFT 특징과 SURF, 그리고 이진 특징을 이용한 LBP(Local Binary Pattern), BRIEF(Binary Robust Independent Elementary Features), BRISK(Binary Robust Invariant Saleable Keypoints), LIOP(Local Intensity Order Pattern for Feature Description) 등이 있다.
이 중에서 SIFT와 SURF, LBP, LIOP를 살펴보면, SIFT 서술자 추출은 검출된 특징정보를 기반으로 해당 스케일에서의 영상 패치를 얻어 4 by 4 영역을 나누고 각 영역에 대해서 8단계로 구성된 각도 히스토그램을 얻은 다음, 이 값을 모아 128차원의 특징 벡터로 구성하고, 밝기 변화에 강인하도록 정규화하는 방식이다. SURF 서술자 추출은 특징 검출 영역의 패치에 대해서 4 by 4영역을 할당하고, 각 영역을 4영역으로 나누어서 특징 벡터로 구성하는 것인데, 이렇게 되면 서술자 차원은 64차원이 된다. LBP는 영상의 텍스처를 인식하기 위해서 처음 제안된 방식으로서, 영상의 중심 픽셀과 주변 픽셀 간의 차 정보를 이용해서 생성한 값을 서술자로 활용한다. 한편, LIOP는 서술자 추출 영역에서 서술자 추출 시 중심영역에서 떨어진 주변의 밝기정보의 순서를 이용하는 방식이다.
(3) DB 검색 (database search)
추출된 특징들로 구성된 DB에 대해서 정합 및 검증을 위한 후보군을 선정하는 과정으로서, 대용량의 서술자를 효율적으로 검색하는 기술이 핵심이 된다. 대표적인 검색 구조로는 VT(Vocabulary Tree)와 REVV(Residual Enhanced Visual Vector), VLAD(Vector of aggregated local descriptors) 및 FV(Fisher Vector)를 기반으로 한 방법들이 사용되고 있다.
Vocabulary Tree는 영상 서술자 값들을 BoW에서의 단어의 개념으로 생각하고 검색의 대상이 되는 영상으로부터 Vocabulary Tree를 구성하는 방식이다. 이 트리를 기반으로 검색을 하게 되면 각 비주얼 워드(visual word), 즉 특징의 빈도에 따라 후보군을 생성하고, 정합 및 검증방법에 의해서 결과를 결정하게 된다. 이러한 VT 기반 방법은 비주얼 워드의 빈도수만을 이용하기에 정보를 표현하는데 있어 제약이 있다는 단점이 있는데, 이를 개선하기 위한 것이 VLAD이다. VLAD는 해당 비주얼 워드를 선택한 특징들의 통계적 특성을 반영하는 방법으로, Fisher Kernel의 일종으로 생각할 수 있으며, REVV도 VLAD의 변형으로 생각할 수 있다.
(4) 정합 및 검증(matching and verification)
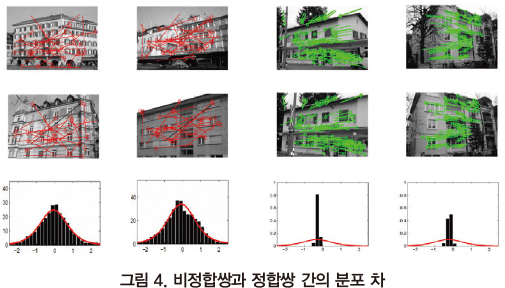
정합 및 검증은 특징으로 구성된 DB에서 후보 영상들에 대해서 실제 일치하는 정보가 있는지 확인하는 과정으로 서술자 값과 위치 정보를 이용하여 기하학적인 관계를 추정한다. 일반적으로 RANSAC(RANdom SAmple Consensus)이란 방법이 활용되는데, 모델을 가정하고, 그 모델이 맞는지를 반복적으로 검증하는 방법이다. 이 외에 정합쌍과 비정합쌍 간의 통계 모델을 통한 방법도 제안되고 있다. 이는 정합 후보쌍의 로그 거리비율에 따라 정합 유무를 판단하게 되는데, RANSAC보다 빠른 이점이 있다. 그림 4 참고.
MVS 관련 시장 현황
구글은 ‘Goggles’라는 이미지 인식 응용 프로그램을 2010년 10월부터 서비스하고 있다. 아직까지는 동물, 식물, 자동차, 가구, 의류 등은 검색이 어렵고, 최대 3개까지의 물체를 인식할 수 있다.
아마존은 자사의 온라인 쇼핑 서비스와 MVS 기술과의 시너지 효과를 기대하고 영상검색 기업인 ‘Snap Tell’을 인수하였다. 그 이후 상품 검색 앱 ‘Flow’, 신발 전용 검색 앱 ‘Fabulous’를 출시했다. 아마존은 현재 A9.com이라는 회사를 따로 두어 미래 기업 성장 동력의 발판으로 삼으려 하고 있다.
한편 퀄컴은 ‘Vuforia’라는 응용서비스 개발 플랫폼을 제공하고 있다. 현재는 영어 문자 인식, 3D 객체, 영상 인식 등을 지원하고 있으며, 현재 등록된 개발자만 130여개국 8만 명을 넘고, 플랫폼을 활용한 앱이 6,500개를 넘고 있다고 한다.
HP는 클라우드 기반의 ‘Multimedia Analytic Platform’ 서비스를 개발하였으며, 이 서비스를 통해 얼굴인식, 특징 추출 및 영상관련 AP(Application Programming Interface)를 손쉽게 활용하여 관련 서비스를 개발할 수 있다.
제록스 역시 이 분야에 뛰어들었는데 Open Xerox를 통해 영상 검색에 대한 다양한 기술을 소개하고 있으며, 특히 대용량 영상 검색 기술을 선도하고 있다.
마이크로소프트는 노키아 인수를 통해 MVS 기술과 관련된 ‘Point&Find’ 서비스 기술을 확보하였으며, 윈도우폰에 QR코드, 바코드, CD, 책표지 등을 검색할 수 있는 ‘Bing Vision’ 앱을 제공한 바 있다.
자료출처 | ETRI 전자통신동향분석(www.etri.re.kr/ettrend/)




