


앤비젼의 프레임 그래버 정복기
PCI Express, FPGA, PA
국내 머신비전분야의 선두를 지키고 있는 앤비젼이 프레임 그래버에 대해 교육자료를 만들었다. 먼저 기존 PCI 버스의 한계를 극복한 PCI Express를 알아보자. 그리고 현재 머신비전분야에서 사용자와 개발자의 요구로 계산량이 늘어나고 있기에 이에 대응하기 위해 전용 전처리 프로세싱 하드웨어(Pre-processing Hardware)를 사용한다. 그 중 대표적으로 두루 쓰이는 하드웨어인 FPGA와 Matrox에서 제공하는 PA(Pixel Accelerator)를 살펴보자.
자료제공 | 앤비젼(www.envision.co.kr)
PCI Express
PCI Express는 기존 PCI 버스의 한계를 대체하기 위해 PCI SIG에서 2002년 10월경 공식적으로 발표한 3GIO(3rd Generation Input/Output) 표준이다.
PCI는 병렬버스방식, 동기식 데이터 전송, Multi-Drop 방식으로 높은 데이터 전송률과 여러 개의 장치들을 동시에 사용할 수 있는 장점을 가지고 있는 반면 신호왜곡에 취약하고 여러 장치들과의 동기화로 인해 클럭이나 전압 설계에 제한이 되는 단점도 있다.
그 결과 PCI는 33MHz, 32비트, 5V라는 고정된 사양만을 가지고 있었다. 이후 PCI가 66MHz, 64비트, 3.3V 등의 확장규격으로 진화하였지만 여전히 PCI의 특성이 가지고 있는 구조적 한계가 내재되어 있었다. 이를 직렬 버스방식, P2P 통신 방식으로 해결하려 한 것이 PCI Express다.
이는 Hyper Transport와 같이 Dual Simplex 방식의 버스다. 즉, 단방향 버스가 2개 1조로 구성되어 하나의 버스는 데이터 송신에만 다른 하나의 버스는 데이터 수신에만 사용되는 구조다.
PCI Express의 기본 동작 클럭이 2.5GHz이고, 한 레인(lane, 통로)당 100MB/s의 대역폭을 가지므로, PCI Express의 전송 대역폭은 200MB/s가 된다. 이 속도는 기준속도이며 규격상 2X, 4X, 8X, 12X, 32X의 전달폭을 가질 수 있다.
PCI는 132MB/s, PCI-X는 1,064MB/s의 최대 전송속도를 가지는데 비해 PCI Express 32X의 경우 최대 6.4GB/s의 전송속도를 가지므로 현존하는 어떠한 주변장치와의 연결도 문제가 없다.
기존 PCI나 Hyper Transport의 경우 트리(Tree)구조가 가능하지만 PCI Express는 순수한 P2P 형태의 구성만 가능하여 하드웨어 장치들과의 연결을 위해 스위치(Switch)를 이용하고 있다. 스위치 적용구조를 통해 PCI Express는 높은 확장성과 함께 높은 I/O 성능 또한 보장받을 수 있다.
PCI Express의 큰 장점은 보드간 연결(Board-to-Board)을 지원한다는 것이다. 기존 PCI를 그대로 계승하면서도 주변기기의 연결을 고려하여 설계되었다.
따라서 PCI 슬롯과 나란히 구성될 수 있는 내장형 저속 PCI Express 인터페이스, 4X 이상의 속도를 구현하기 위해 별도의 슬롯으로 구성된 고속형 PCI Express 인터페이스, 외장 장치를 위한 인터페이스 등 다양한 구성이 가능하다.
PCI에서 좀 더 병렬규모를 크게하고 클럭을 높인 PCI-X는 서버급의 고가 시스템에 주로 적용된 반면 PCI Express는 Pentium 4급 저가형 시스템에도 탑재할 수 있는 장점이 있으며 기존 드라이버 인터페이스와의 뛰어난 호환성으로 인해 신규 드라이버 개발 부담이 적다는 장점도 있다.
영상처리 위한 FPGA 이해
FPGA
FPGA(Field-Programmable Gate Array)란 말 그대로 사용자가 필요한 형태의 기능을 프로그래밍 할 수 있는 단위 프로세싱 유닛의 모음이다.
일반 사용자가 한가지의 형태로 사용할 수 있는 IC 집적회로를 사용할 수도 있지만 조건이 변하면 IC 회로를 다시 설계하여 제작해야 한다. 이런 경우 FPGA를 사용하여 회로를 구성하면 회로단과 주변기기의 변화에 하드웨어적인 변화없이도 소프트웨어적으로 대응할 수 있으므로 FPGA는 인터페이스나 프로세싱 하드웨어를 제작하는 개발자가 가장 많이 사용하는 하드웨어 중 하나가 되었다.
FPGA를 사용하기 위해서는 하드웨어에 맞는 언어를 사용해야 하는데 일반적으로 HDL(Hardware Description Language)를 사용한다. 이런 언어들은 대부분 하드웨어를 컨트롤해야 하는 언어이기 때문에 프로그래밍을 위해서 각 유닛의 동기와 구성에 대한 하드웨어적인 지식이 필요하게 된다.
한편 Matrox에서 제공하는 PA(Pixel Accelerator)는 일반적으로 사용하는 영상처리 알고리즘에 최적화하여 설계한 영상 전처리 전용 ASIC 프로세서라고 할 수 있다.
PA(Pixel Accelerator)
PA의 하드웨어적인 면을 살펴보면 일반적으로 전처리 계산에 많이 사용하는 Convolution, Morophology 등에 최적화되어 있는 Neighborhood Engine과 ALU(Arithmetic and Logic Unit)가 함께 하나의 유닛으로 구성되며 PA는 64개의 유닛으로 구성되어 있다.
단위 유닛은 Convolution에서 특히 그 효과를 발휘한다. 1단위의 3×3 Kernel을 계산하기 위해서는 일반적인 곱셈 계산이 9번 필요한데 Neighborhood Engine에서는 클럭 단위로 전체 계산을 한번에 수행하며 그 결과에 대해 ALU에서는 예외처리나 영상 대 영상의 비교 등 후처리 공정을 담당한다.
더욱 강력한 기능은 이러한 ALU 기능에 사용자가 원하는 알고리즘을 넣을 수 있는 DTK(Developmet ToolKit)를 통해 구현이 가능하다. 이를 이용하면 전처리 과정을 사용자가 최적화하여 연산시간을 최소화 할 수 있는 가능성을 제공하고 전처리 과정 중 원하는 결과에 최대한 근접한 프로세싱 능력을 제공하여 불필요한 연산을 줄이는 효과도 있다.
Neighborhood Engine에서 동작되는 여러 가지 계산 모드는 하나의 영상으로 4개의 다른 Kernel 계산을 수행 할 수 있다. 계산 속도를 높이기 위해 한번에 4개의 Pixel을 단위 유닛으로 보내어 계산 속도를 4배로 올리는 동작 모드다.
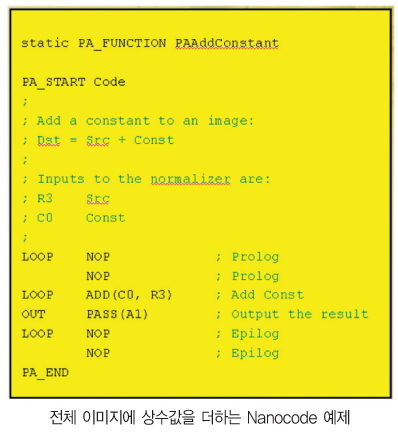
ALU를 프로그램하기 위해서는 Nanocode라는 전용 하드웨어 언어를 사용하게 되는데 Nanocode는 FPGA에 비해 프로그램이 상대적으로 쉽다. 내부에서 영상처리에 맞게끔 하드웨어를 구성했기 때문에 하나의 기능을 위해 대략 10줄 정도면 대부분의 프로세싱 알고리즘을 구현할 수 있다.
FPGA 활용
회로 설계를 생각대로
FPGA는 일반적으로 디지털 신호기로 구성되는 전기회로를 개발자가 원하는 설계대로 구성하기 위해 쓰이는 제품이다. 예전에는 주로 단순한 1차원 신호를 처리하기 위해 사용됐지만 현재는 복잡한 신호나 고속화된 신호를 처리하기 위해 사용된다. 예를 들어 요즘 각광받는 LCD Display에 사람이 잘 이해할 수 있는 색을 구현하는 디지털회로를 이런 FPGA로 구현하는 경우도 있다.
영상 전처리 FPGA
그러나 이렇게 색을 다루는 경우처럼 1차원 신호처리보다 2차원 영상신호를 처리하기 위해서는 많은 회로를 구성해야 한다. 최적화를 거친다고 하더라도 대량의 논리신호 처리기(Gate 또는 Logic Element)가 필요하다.
일반 머신비전 영역에서는 보통 카메라에 들어오는 디지털 신호를 보드의 메모리로 저장하거나 호스트 시스템으로 전송하는 인터페이스 용도로 사용되지만 요즘은 하드웨어적인 효율성 때문에 영상 전 처리용으로 사용되는 추세다.
상용 라이브러리의 활용
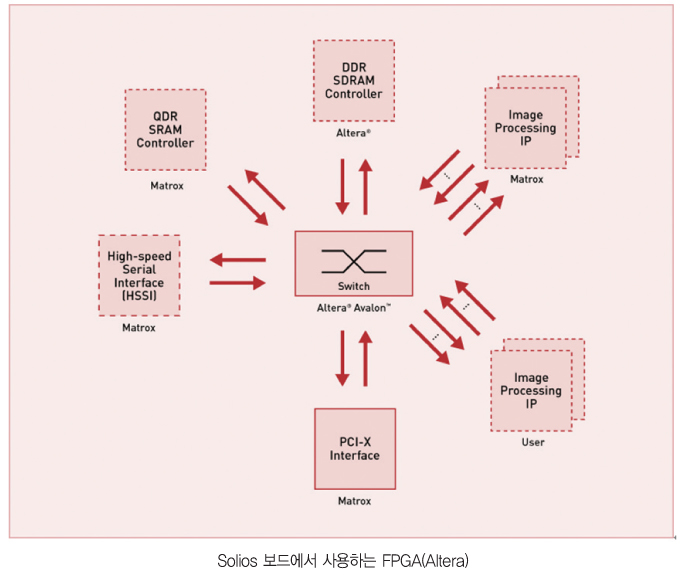
영상처리를 위해서는 개발자가 직접 VHDL을 이용하여 영상처리 알고리즘을 제작할 수도 있지만 많은 경험에 의한 노하우와 코딩 시간과 테스트 시간이 필요하다. 그래서 Altera에서 제공하는 상용 라이브러리는 FPGA 온보드 프로세싱이 가능한 프레임그래버를 제작한다. Matrox에서는 Altera기반의 하드웨어에 최적화된 SOPC 모듈을 제공하여 사용자에게 최소한의 개발시간으로 알고리즘을 이식할 수 있도록 돕는다.
Matrox에서 제공하는 SOPC 프로세싱 모듈
1. ADD-a-constant
2. Bayer Filter
3. 3×3, 16×16(sym) Convolution
4. Distance
5. Gain & offset
6. Histogram
7. LUT Mapping
8. Min/Max
9. Plane separator
10. FFT
11. RGB to HSL Color space converter
12. Splitter
13. Grayscale Erosion and Dilation
14. Warping
Host와 FPGA 프로세싱 비교
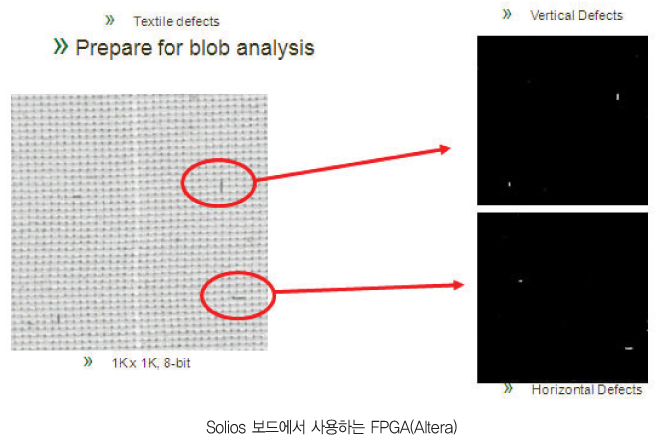
일반 모직물을 검사할 때 하나의 예로 오물이나 오류를 수평 및 수직 성분으로 나누어 검사하는 경우가 있다. 이 경우는 두 개의 성분을 같이 검사하는 알고리즘을 사용할 경우 검출 성능이 떨어지기 때문에 수평성분과 수직성분의 특화된 검출 알고리즘을 독립적으로 수행하여 최대의 성능을 얻는다.
수평성분과 수직성분의 결점을 검출하는 알고리즘을 대략 정리하면 노이즈 제거 및 수평 및 수직의 검출, 이진화 등이다.
일반 호스트에 비해 FPGA가 갖는 특징은 데이터가 파이프라인 형식으로 처리되기 때문에 단일 연산에서는 프로세싱의 속도가 Intel CPU에 비해 느릴 수 있다. 하지만 복잡하거나 다양한 프로세싱이 필요한 애플리케이션에서는 FPGA의 속도가 훨씬 빠르다.
Host 프로세싱의 한계를 넘다
유연성이 있는 FPGA 솔루션으로의 온 보드 프로세싱이 Host 프로세싱의 한계를 없애고 조화로운 고성능 시스템으로 변모시킬 것이다.




