


객체 인식·장면 분석에 도움 주는 알고리즘
작업정보를 인식·수행하는 방법 선봬 … 자동영상협회
자동영상협회(AIA)의 2013년 비즈니스 컨퍼런스 도중 자리를 뜬 이가 있다면 흥미로운 발표 두 가지를 놓친 셈이다. 두 가지 발표 모두 작업 과정에서 객체 및 현장 정보를 인식하고 작업을 수행할 수 있는 알고리즘에 대한 내용을 담고 있었다. 이 분야에 대한 최신 연구 성과를 발표했던 것.
자료제공 | 자동영상협회(www.visiononline.org)
MIT 컴퓨터과학 및 인공지능 연구소(CSAIL) 박사인 오드 올리바 교수는 ‘컴퓨터 비전의 최첨단: 인간 시각에서 인공 시각으로’라는 제목으로, 일련의 이미지를 통해 인간과 머신비전이 받아들이는 시각적 인식 차이에 대해 발표했다.
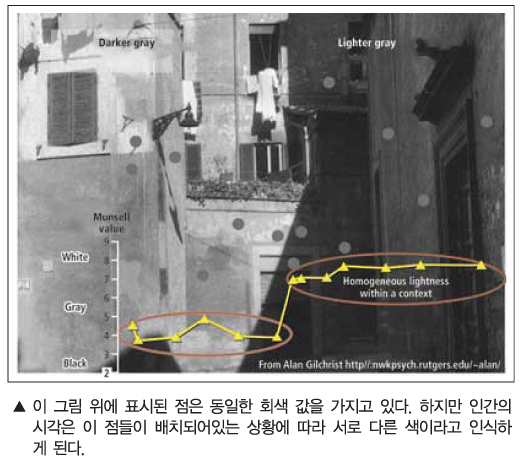
올리바는 우선 럿거스대학에 재직 중인 앨런 길크리스트 교수가 만든 이미지를 활용해 인간이 인식할 수 있는 한계에 대해 나타냈다(그림 참조). 그림 안에 있는 점들은 모두 동일한 회색을 나타내고 있지만, 사람의 눈은 어떤 상황 혹은 상태에 점이 있느냐에 따라 서로 다른 색으로 인식하게 된다. 즉, 인간의 눈은 어두운 배경 위에 있는 회색을 밝은 배경 위에 있는 회색보다 더욱 밝게 느낀다. 컴퓨터는 회색 값이 서로 다른지 혹은 같은지를 쉽게 확인할 수 있지만 인간의 눈은 그때그때 상황에 맞는 배경 정보를 활용해 회색의 농도 및 밝기를 인식하게 된다.
인간의 시각이 불완전한 이유는 또 있다. 바로 인간의 기억력 때문이다. 인간은 특정한 장면이 다른 장면과 일치하는지의 여부를 ‘기억’으로 판별하는데, 이 기억의 혼동 혹은 불일치 때문에 서로 다른 결과를 낳게 되는 것. 예를 들어 사람들에게 일반적인 방 사진을 여럿 제시했을 때, 사람들은 서로 비슷하지만 다른 방을 보여주었음에도 불구하고 ‘같은’ 방을 보았다고 주장했다.
여기서 연구자들은 다시 몇 가지의 알고리즘을 사용해 이미지가 서로 유사한지 여부를 분류한다. 이 분류 알고리즘은 다수의 상이한 변환 알고리즘을 사용하고 있는데, global visual features(GIST 등), scale-invariant feature transforms(SIFT), histogram of gradients(HOG) 등이 그것이다. 올리바는 이러한 알고리즘을 배치했을 때 대규모 장면 분석에서 인간 능력 대비 50% 이상 효율적으로 수행할 수 있다는 것을 증명했다. 일리노이대학교 어바나-샴페인캠퍼스 교수인 데이비드 포사이스는 ‘현대적인 접근: 컴퓨터 비전’ 발표를 통해 영상을 분류하는 과정에서 교육 샘플을 늘려 분류 정확도를 높이는 방법을 선보였다.
많은 분류 과정에서 환경적 지식을 사용한다. 하지만 데이비드 포사이스는 환경적 지식을 보다 효율적으로 활용할 수 있는 방법에 대해 이야기했다.
데이비드 포사이스의 말에 따르면, 환경 지식은 일부 응용프로그램에서 유용하게 사용할 수 있지만 모든 이미지 분류 문제를 해결하는 만병통치약처럼 사용할 수는 없다.
그렇다면 영상 분류 절차에서 인간이 영상을 정확히 인식할 수 있도록 분류 작업을 수행하는 SIFT 알고리즘을 구현하는 방법에는 무엇이 있을까? 포사이스는 이 질문에 대답하는 것은 다른 연구자의 몫이지만, 어떤 알고리즘이 특정 작업에 유용하다는 것을 입증하게 된다면 해당 알고리즘을 사용하면 된다고 귀띔했다.
두 사람의 발표 사본은 자동영상협회 누리집에서 확인할 수 있다.


